前置条件
启动服务器
拉取模型:bash
bash
http://127.0.0.1:18181。保持该终端开启,并在另一个终端中发送请求。运行 geniex serve -h 查看所有可配置选项。
POST /v1/chat/completions
为给定对话创建模型响应。支持 LLM(纯文本)与 VLM(图像 + 文本)。LLM 请求
Example Value
分离推理内容(reasoning_content)
思考模型默认会把思维链放入message.reasoning_content,让 content 只保留最终回复。如需把原始推理保留在 message.content 中,可在 /v1/chat/completions 请求体中将 reasoning_format 设为 none:
deepseek 是默认值;deepseek、deepseek-legacy 和 auto 会分离推理内容,none 则保留内联推理。此设置不会关闭模型的推理(与 enable_think: false 不同),流式响应和工具调用请求也适用。使用 OpenAI SDK 读取分离字段的方式见 Python client 示例。
通过 Swagger UI 试用
在浏览器中打开http://127.0.0.1:18181 即可访问内置的 Swagger UI。
步骤 1. 展开 POST /v1/chat/completions 端点,查看示例请求体与 schema。
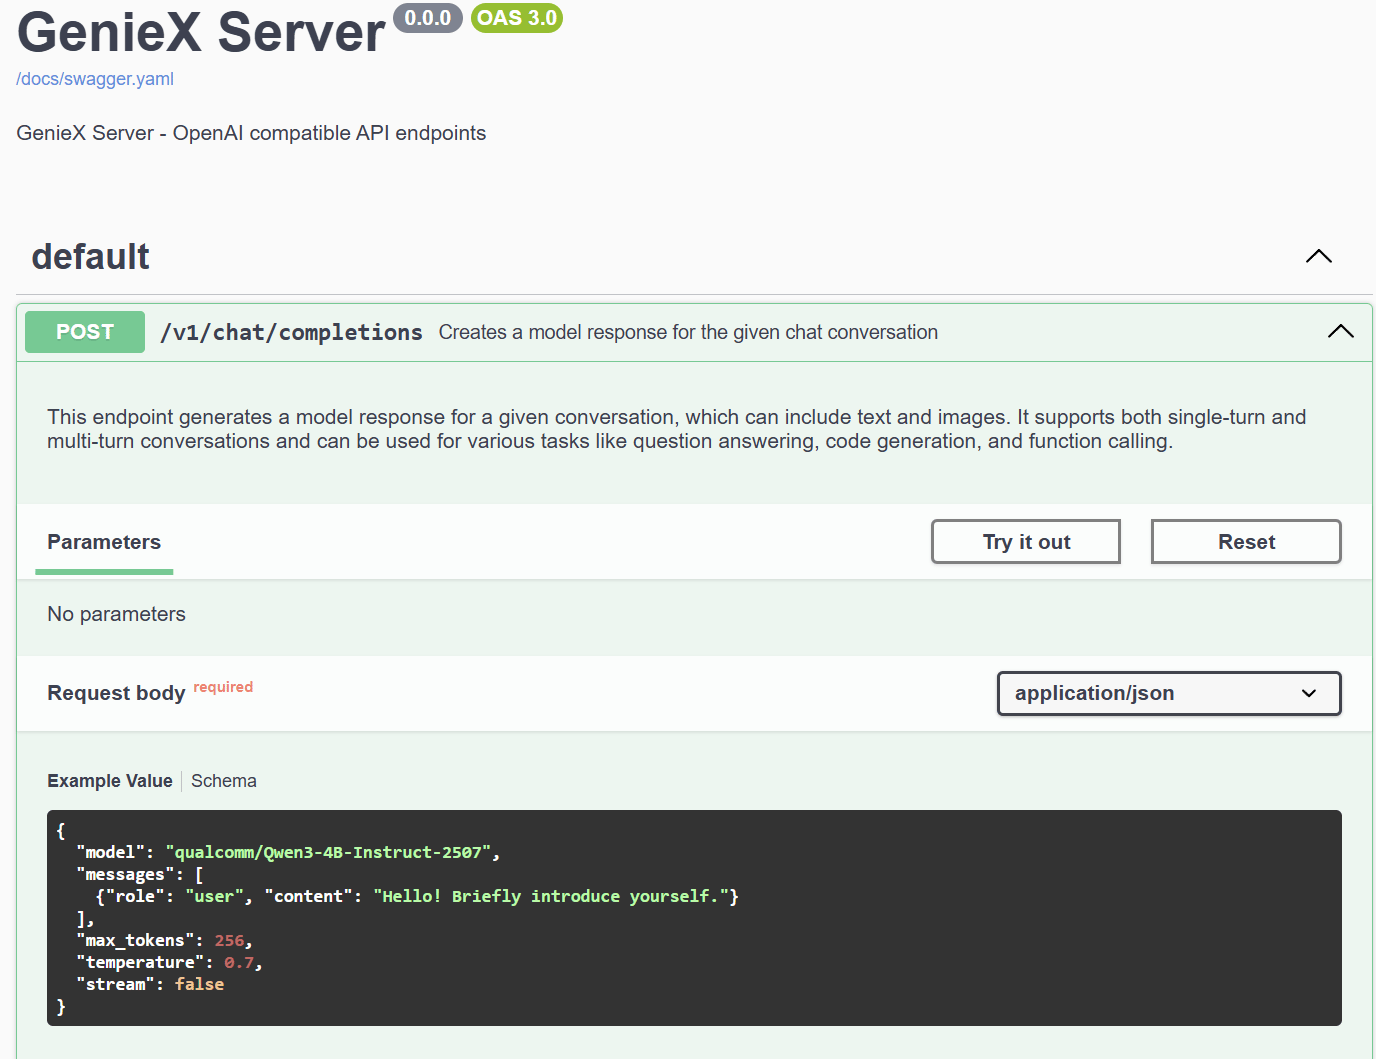
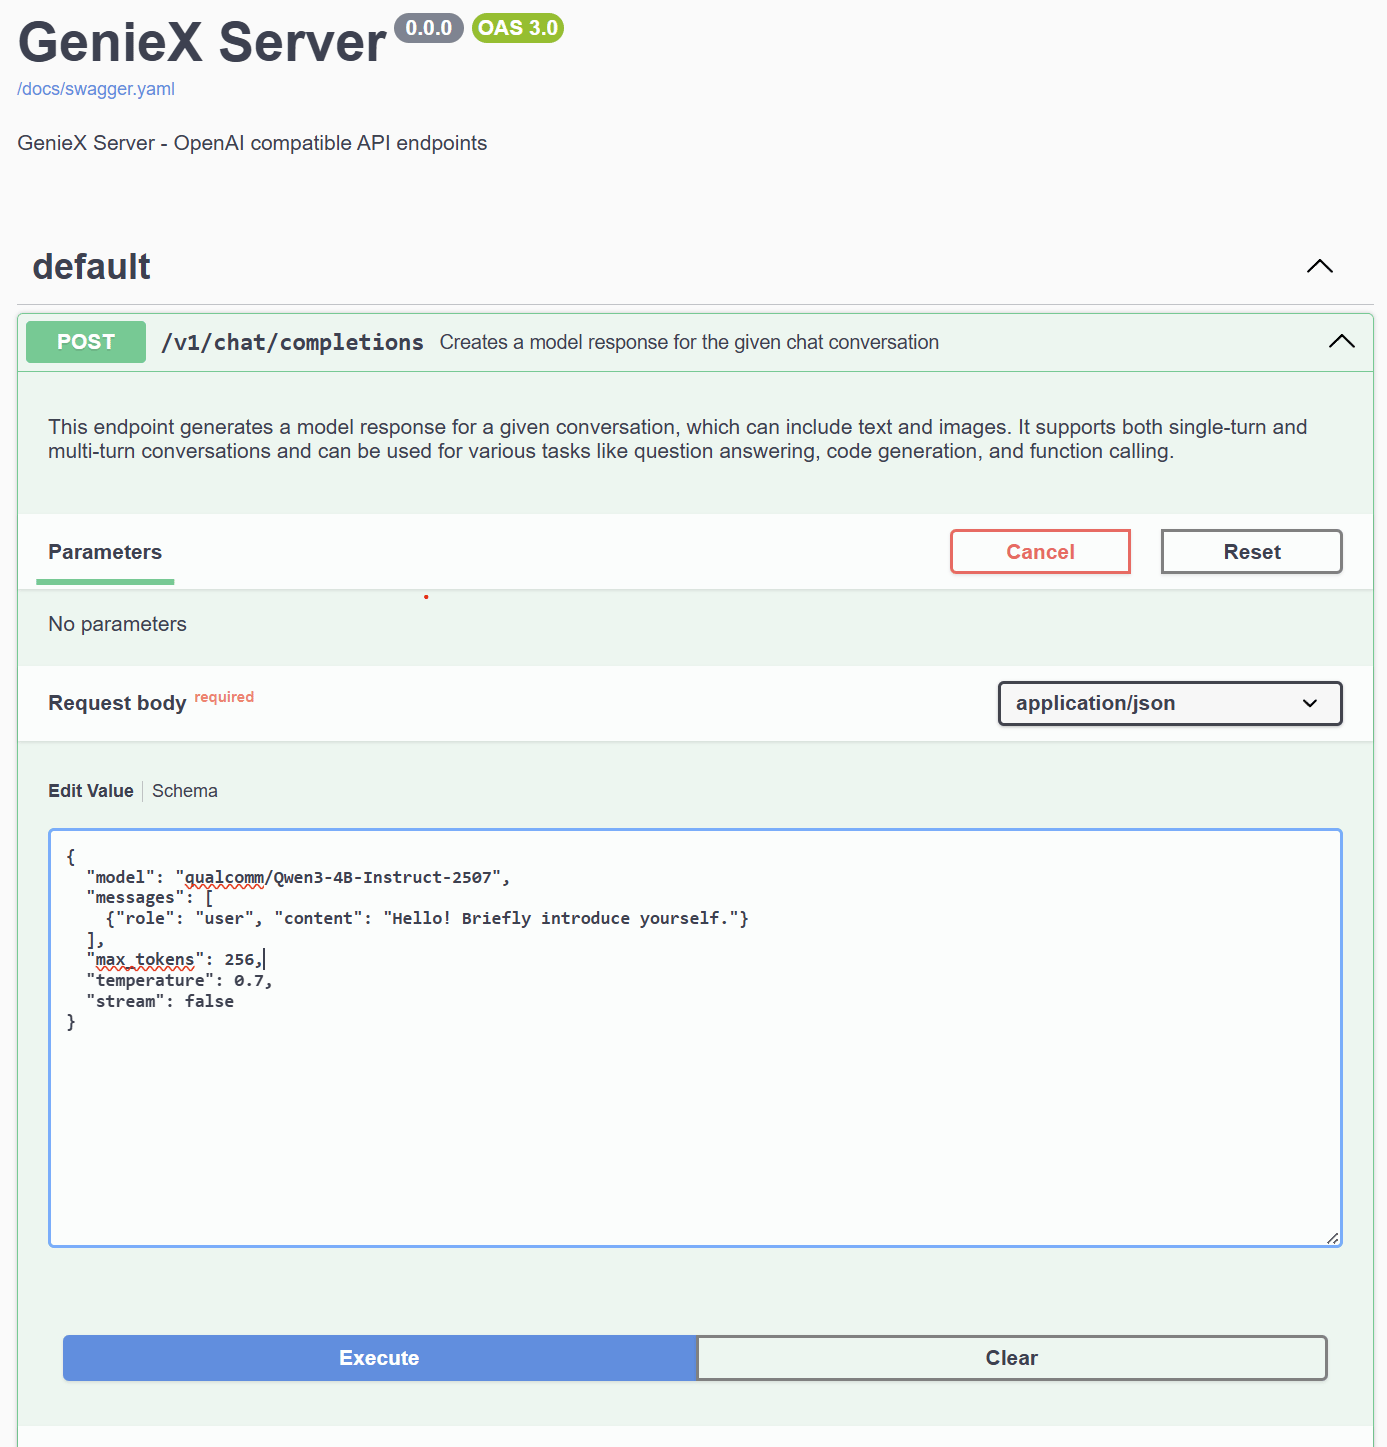
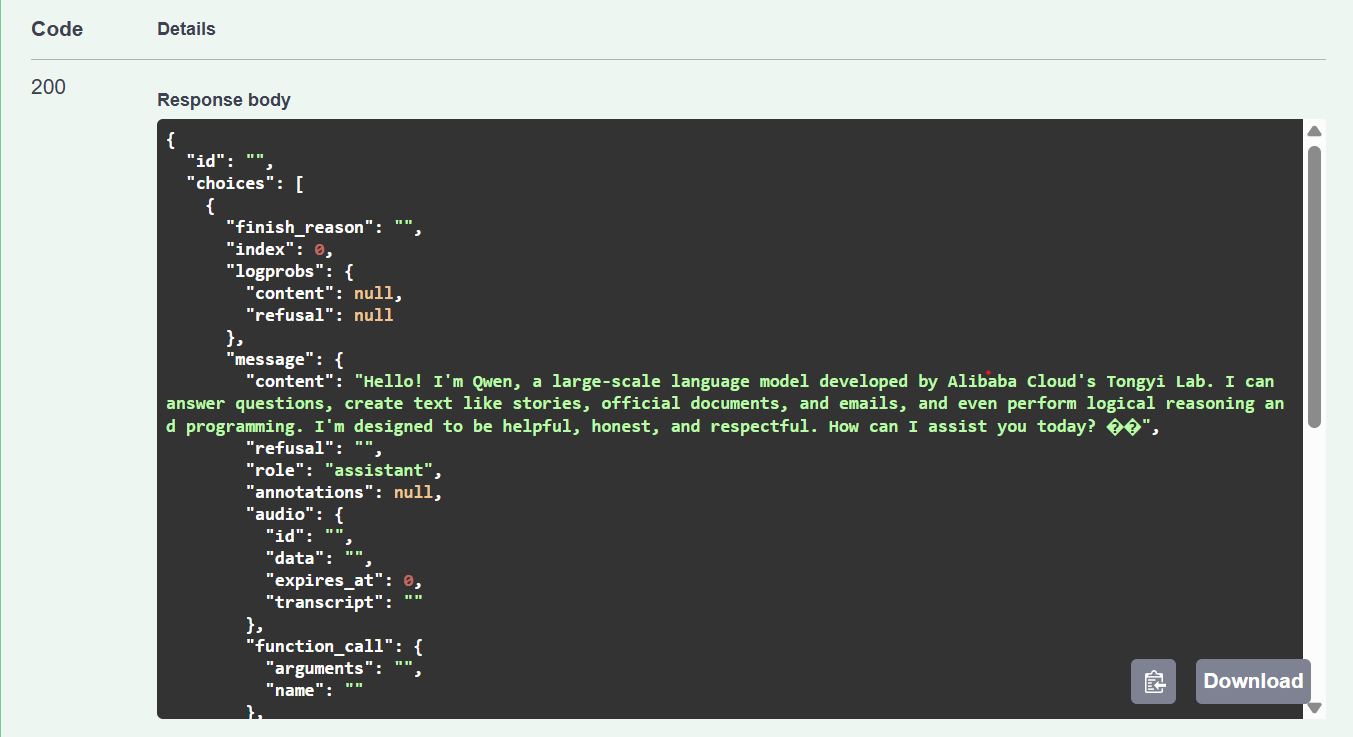
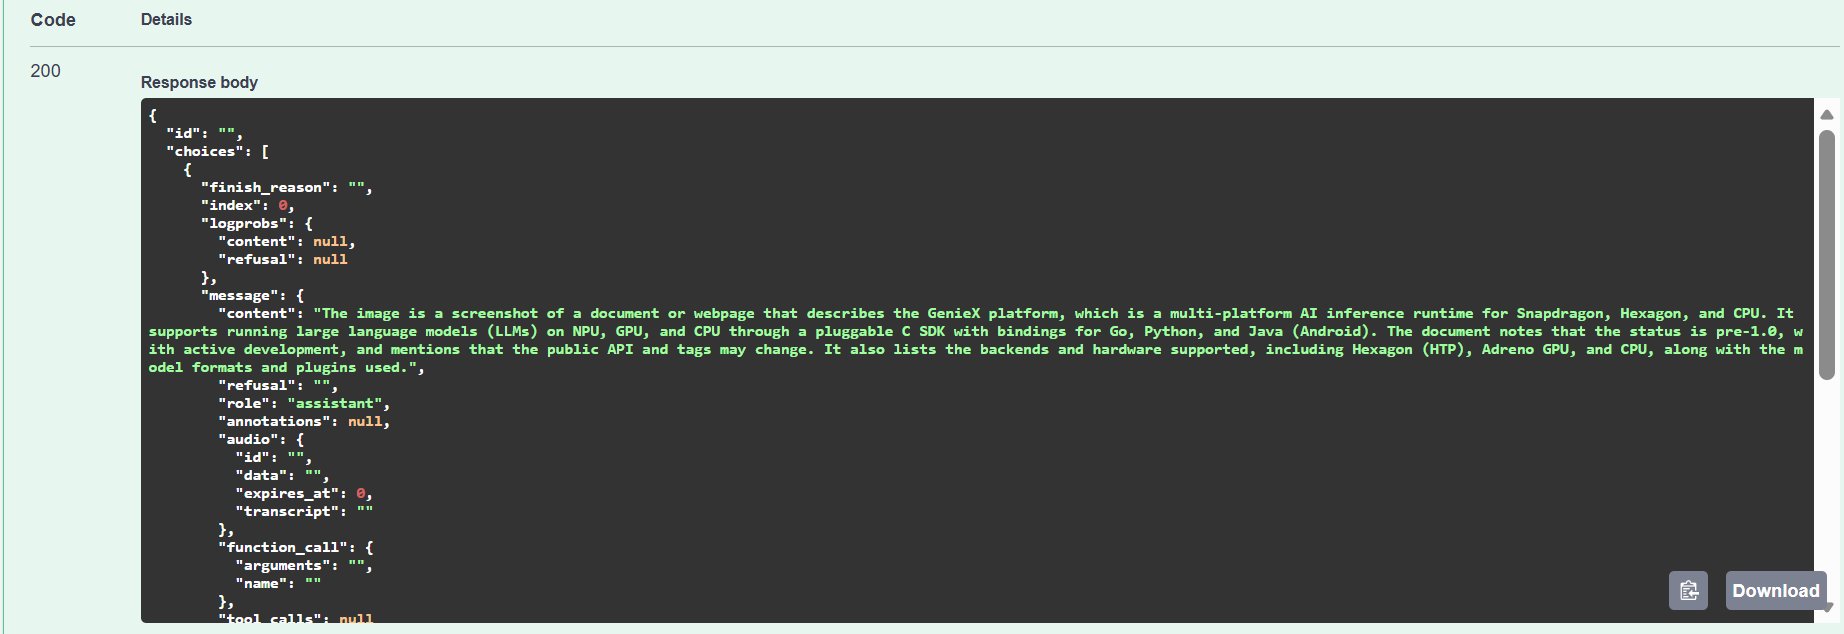
200 状态码以及模型生成的回复。
VLM 请求
image_url.url 支持三种格式:
在 Docker 中运行? 本地路径会在容器内解析,而不是主机。安装命令已经把
$PWD/data 挂载到 /data——把图片放进去,然后传 /data/cat.jpg 即可。或者直接用 HTTP URL 或 base64 data URL,绕过文件系统。Example Value
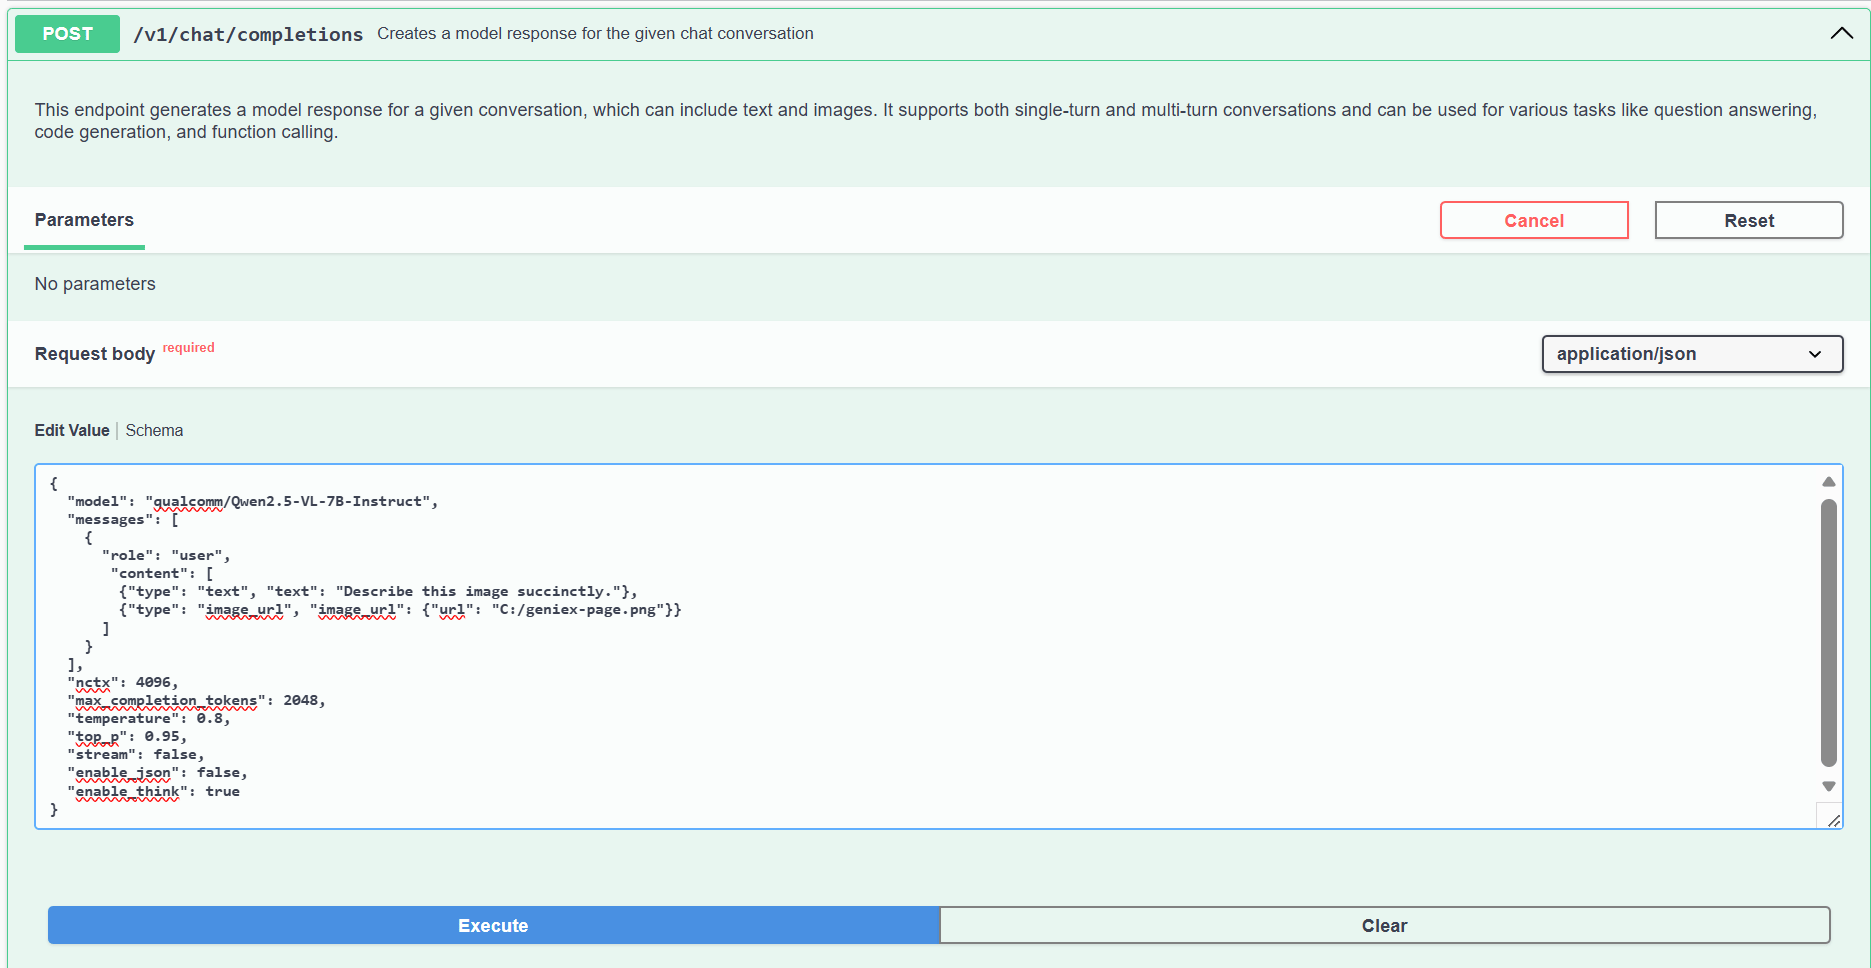
image_url.url 指向本地图片,然后点击 Execute。
POST /v1/completions
对prompt 生成原始续写,不套用聊天模板 —— 提示词会原样传给模型。适用于自行构造完整提示词的客户端,例如编辑器的 fill-in-the-middle(FIM)代码补全:把模型的 FIM 标记直接写进 prompt。仅支持 LLM 模型。
Example Value
choices[0].text 即原始补全内容,可直接插入光标处。stream、stop、echo 及采样参数(temperature、top_p、top_k、min_p、repetition_penalty、seed)与 /v1/chat/completions 行为一致;不支持 suffix —— 请改用模型的 FIM 标记把后缀编码进 prompt。
POST /v1/decisions
使用已导入 GenieX 缓存的llama_cpp LLM 或 VLM,按顺序评估 predicate、choice 和 score 问题。此端点采用 OpenAI Decisions 的请求与响应结构。带有 systemone 的模型使用对应的 OpenJEV、LEV 或 Nimble 决策路径及模型 temperature;缺少 decision.type 时默认按 OpenJEV 处理。没有 systemone 时使用常规 chat template 和通用选项 prompt,temperature 回退到 1.0。LEV 的 choice 会平均两种选项顺序,predicate 使用九档评分;LLM 和 VLM 均通过原生 logits 评分(LEV 模型本身仅支持文本)。VLM 还可评估内联图像和音频。
input 可以是非空文本字符串,也可以是包含 input_text、input_image 和 GenieX 扩展 input_audio 部分的 user message 数组。图像(image_url)和音频(input_audio.data)复用 chat 端点的 SaveURIToTempFile 路径,支持本地路径、file://、HTTP(S) 及 data URL。音频也与 chat 一样支持配合 input_audio.format(例如 wav)传入原始 base64。每种最多 8 个,并要求 VLM 支持相应模态。每个问题的 name 可选但必须唯一(省略时响应的 name 为 null);choice 支持 2–255 个值(上限还受模型词表限制),score 支持 2–10 个等级,最多 64 个问题。响应中的 answers 数组与问题顺序一致:predicate 返回为真的概率,choice 返回选中值,score 返回零起始等级索引。LLM 和 VLM 均通过 logits 返回概率及 confidence,且 output_tokens 为 0。请将示例中的 model 替换为 geniex list 中的缓存模型名称,而非 GGUF 路径。
Python 客户端(OpenAI SDK)
由于服务器使用 OpenAI 协议,可直接将官方openai Python 客户端指向本地端点,复用任意已有的 OpenAI 代码。先通过 pip install openai 安装,然后创建 client:
python
client。请把 model 替换为已拉取的模型;可选的 :<precision> 后缀(例如 Q4_0、Q4_K_M、Q8_0)选择量化变体——Q4_0 推荐用于 Hexagon NPU 上的 llama.cpp。详见支持的精度(量化)。
流式(Streaming)
按 delta 到达顺序逐段打印:python
Chat completion(非流式)
单次请求、单次响应,不启用流式——标准的 OpenAIchat.completions.create 形式。enable_think=False 关闭 Qwen3 默认的 <think>…</think> 推理前缀,让回复内容更干净。
python
usage.prompt_tokens 为完整 prompt 长度,包含从 KV cache 复用的 tokens;usage.prompt_tokens_details.cached_tokens 为其中复用的部分(未命中时为 0),timings.prompt_n 为实际计算的 tokens。QAIRT 模型暂不统计复用,其 prompt_tokens 只包含实际计算的 tokens。
分离推理内容(reasoning_content)
思考模型默认会把思维链放入 OpenAI 标准的message.reasoning_content 字段,让 content 只保留干净的回复。仅在需要把原始推理保留在 message.content 时,才需在请求体中传入 reasoning_format="none"。
reasoning_format 与 enable_think 是两件事:enable_think=False 让模型不产生思维链;默认的 reasoning_format="deepseek" 让模型照常思考,但把思维链移出 content。取值 deepseek(默认)、deepseek-legacy 和 auto 均触发分离,none 则保持原样内联。工具调用请求同样生效(含流式):思维链会先分离出来,再对回复扫描工具调用。python
delta.reasoning_content 增量返回,最终回复以 delta.content 返回。
工具调用(Tool calling)
函数/工具调用使用标准的 OpenAItools schema。服务器会从模型生成的文本中解析工具调用(<tool_call>…</tool_call> 标签或 ```json 代码块),并以 OpenAI tool_calls 形式返回。VLM 也走同一条路径——模型可以先看图,再决定搜什么、调用工具。
下面的示例用 qualcomm/Qwen3-VL-4B-Instruct 演示两步 agentic 回路:(1) VLM 从照片中识别地标并调用 web_search;(2) 本地执行搜索并将结果回传,VLM 基于结果生成带依据的回复。
一次响应可能包含多个工具调用;请为每个
tool_call_id 回传一条 role: "tool" 消息。设置 parallel_tool_calls: false 可让 llama_cpp 模型每次最多返回一个调用(部分 template 可能忽略)。QAIRT 会忽略该选项。下方示例仅处理第一个调用。Qwen3-VL 稳定触发工具调用需要注意两点:
- 用 system 消息显式说明
<tool_call>…</tool_call>的格式(Qwen3-VL 的 chat template 对该格式的先验没有 Qwen3 纯文本版本那么强)。 - 第二轮不再传入
tools=,也不要再回传图像——否则 VLM 会重复调用工具,且视觉编码器会对同一张图再跑一次。
pip install ddgs —— DuckDuckGo,无需 API key):
python
其他端点
GET /v1/models——列出可用模型。GET /v1/models/{model}——查询指定模型的信息。
Was this page helpful?